 WMX · 随记
向量相似度到底在比较什么:手写一个余弦计算
用标准库实现余弦相似度,再分清相似度、概率和检索阈值之间的区别。
▶ 本文含视频讲解▶ 教学视频手动播放 · 英语讲解
神经网络入门:从图像识别理解模型表示
从简单的神经网络出发,建立对向量、权重与模型表示的直觉。
播放器需要能访问 YouTube 的网络;若这里无法加载,可打开原视频。本文与本地图解仍可独立阅读。
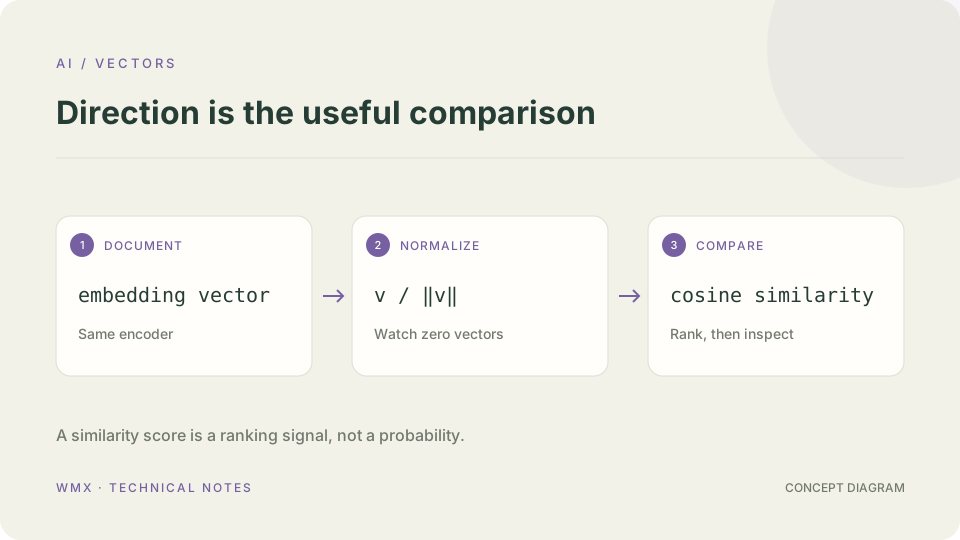
在语义检索中,一段文本会被编码成一串数字。检索系统不直接比较自然语言,而是比较这些向量。问题因此变成:用什么方式衡量“接近”,以及这个接近在当前任务里是否有意义?
余弦更关注方向
余弦相似度等于两个向量的点积除以各自的长度。对于非零实向量,它位于 -1 到 1 之间。方向相同得 1,正交得 0,方向相反得 -1。它把向量整体伸缩带来的长度变化除掉,因此不同于直接使用点积。
from math import fsum, isfinite, sqrt

def cosine(a, b):
    if len(a) != len(b) or not a:
        raise ValueError("vectors must have the same non-zero dimension")
    if not all(isfinite(x) for x in (*a, *b)):
        raise ValueError("vectors must contain only finite values")
    aa = fsum(x * x for x in a)
    bb = fsum(y * y for y in b)
    if aa == 0 or bb == 0:
        raise ValueError("zero vectors have no cosine direction")
    score = fsum(x * y for x, y in zip(a, b)) / (sqrt(aa) * sqrt(bb))
    return max(-1.0, min(1.0, score))

query = [1.0, 0.0, 1.0]
documents = {
    "same-direction": [2.0, 0.0, 2.0],
    "partly-aligned": [1.0, 1.0, 0.0],
    "opposite": [-1.0, 0.0, -1.0],
}
ranking = sorted(
    ((name, cosine(query, vector)) for name, vector in documents.items()),
    key=lambda item: item[1], reverse=True,
)
for name, score in ranking:
    print(name, round(score, 3))
这里是人为构造的小向量,不是实际文本模型输出。实现用于解释公式,面向量级适中的有限数值;极端浮点输入还需要额外数值稳定性处理。
0.82 不是 82% 的正确率
相似度分数是一个排序信号,并非校准后的概率。不同模型、不同数据分布和不同索引设置下,分数范围可能不同。把“高于 0.8 就相关”直接复制到另一个项目,通常没有足够依据。
阈值应通过自己的标注样本选择:低阈值可能找回更多资料,也可能引入无关片段;高阈值可能更干净,却会漏掉措辞不同的正确资料。需要同时观察误报和漏报。
三个兼容性检查
- 查询和资料是否使用兼容的同一套编码方案?不同模型的向量不能仅因维度相同就混用。
- 模型是否要求给 query 和 passage 加不同前缀?要遵循该模型的使用说明。
- 向量是否已归一化,索引使用的距离函数是否与模型建议一致?单位向量上的点积与余弦相同,未经归一化则不一定。
从玩具实现到真实检索
小数据可以逐个计算并排序。资料规模变大后,近似最近邻索引会用一定的召回损失换取查询效率。此时应该分别测量:编码是否表达了任务需要的语义,以及索引是否找回了暴力计算下的高分候选。
要建立神经网络表示的直觉,可以看文章前部的入门视频;它讲的是神经网络基础,而不是某个向量数据库的使用手册。