 WMX · 随记
别只看回答顺不顺:给检索系统做一张评估表
从 Recall@k 和 MRR 开始,将检索质量、回答依据、耗时与成本分开观察。
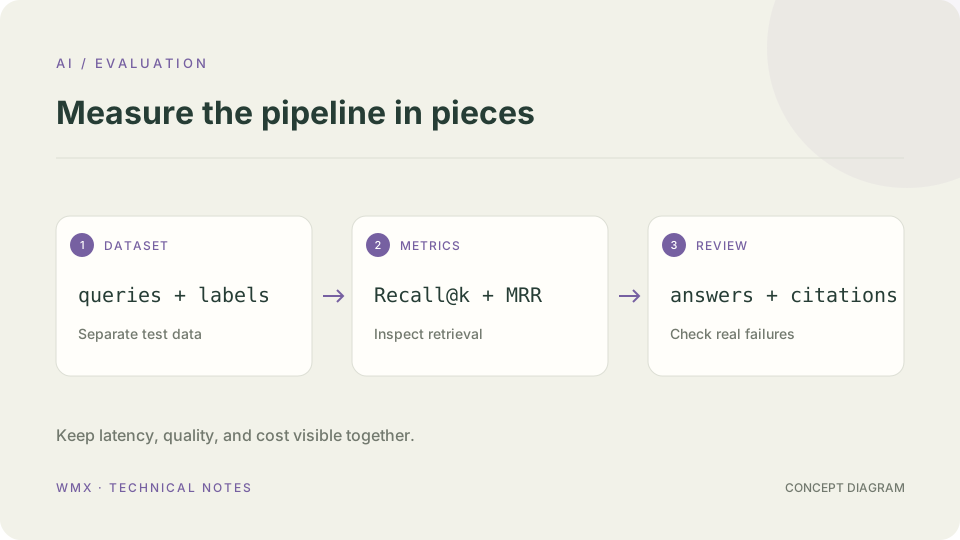
一个答案写得很流畅,可能引用了错误版本的文档;一个答案措辞普通,却完整覆盖了关键步骤。评估 AI 应用时,语言风格只是其中一部分,检索、证据和业务可用性需要各自的检查。
先准备一组能复核的问题
每个问题至少记录相关资料的 ID 和判断依据。问题应该覆盖常见用法、相似概念、过期资料、无答案情况和权限边界。开发集用于调参,测试集用于最终评估,不能一边看测试失败一边无限调整后再把它当作独立结果。
两个简单指标,各自回答一个问题
Recall@k 衡量已标注的相关资料有多少出现在前 k 个结果中。MRR(Mean Reciprocal Rank)关注第一个相关结果的位置:排第一记 1,排第二记 1/2,没有找到记 0,再对查询取平均。两者都不能单独证明最终答案正确。
def recall_at_k(ranked, relevant, k):
    if k <= 0 or not relevant:
        raise ValueError("positive k and non-empty relevance labels required")
    return len(set(ranked[:k]) & relevant) / len(relevant)

def reciprocal_rank_at_k(ranked, relevant, k):
    if k <= 0 or not relevant:
        raise ValueError("positive k and non-empty relevance labels required")
    for rank, document in enumerate(ranked[:k], start=1):
        if document in relevant:
            return 1.0 / rank
    return 0.0

cases = [
    (["a", "b", "c"], {"b", "c"}),
    (["x", "a", "z"], {"a"}),
]
k = 2
recall = sum(recall_at_k(r, labels, k) for r, labels in cases) / len(cases)
mrr = sum(reciprocal_rank_at_k(r, labels, k) for r, labels in cases) / len(cases)
print(f"Recall@{k}: {recall:.2f}")  # 0.75
print(f"MRR@{k}: {mrr:.2f}")       # 0.50
上面的结果来自两条人为构造的样本,只用于演示计算,不能代表任何模型或服务的实际质量。这里对每条查询的指标做等权平均。
无答案问题要单独看
样例函数要求相关集合非空。真正的知识库也应该包含“资料中没有答案”的问题,这类查询需要单独评估错误回答率、错误检索率和拒答质量,不宜用一个人为定义的 Recall 值混在有答案的问题里。
把一张大分数拆成诊断表
| 层次 | 观察内容 | 常见问题 |
|---|---|---|
| 检索 | Recall@k、MRR、过滤结果 | 漏资料、排错序、权限过滤失败 |
| 上下文 | 相关片段占比、截断位置 | 噪声太多、关键段落未进入预算 |
| 回答 | 正确性、引用支持度、拒答 | 编造步骤、引用不支持结论 |
| 运行 | 延迟分位数、错误率、成本 | 尾延迟过高、重试放大负载 |
让比较条件保持一致
保存语料版本、模型配置、切分参数和评估集版本。对同一组查询比较两个方案,并回看指标发生变化的具体样本。不要只挑选改善的例子;指标下降或新出现的失败,往往最能说明系统的边界。
自动评审可以辅助大规模筛查,但评审模型本身也可能偏向文风、受上下文影响或给出不稳定判断。关键业务仍需要人工抽查和可重现的证据。