 WMX · 随记
asyncio 并发要有边界:Semaphore、超时与 TaskGroup
限制同时进行的 I/O,管理任务生命周期,并分清“并发数量”和“等待任务数量”。
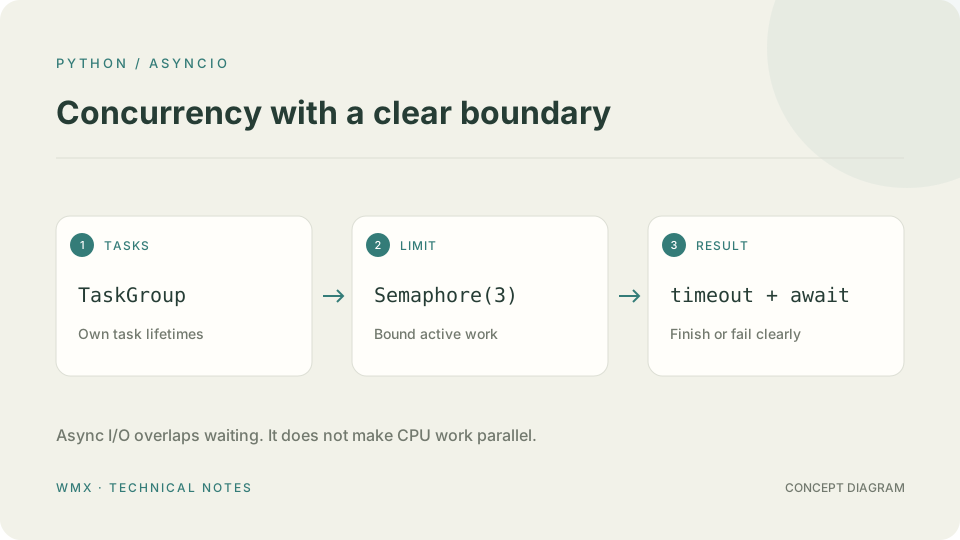
异步程序可以在等待网络时处理其他任务,但等待便宜,并不意味着下游容量无限。为每条数据立刻创建一个请求任务,可能在很短时间内冲垮接口、连接池或本机内存。
示例需要 Python 3.11 及以上。用 asyncio.sleep 模拟 I/O,无外部服务依赖;它不是网络吞吐基准。
先限制真正占用资源的那一段
import asyncio

async def main():
    limit = asyncio.Semaphore(3)

    async def fetch(item):
        async with limit:
            # 超时只覆盖获得许可后的操作,不含排队等待。
            async with asyncio.timeout(1.0):
                await asyncio.sleep(0.05)
                return item * 2

    async with asyncio.TaskGroup() as group:
        tasks = [group.create_task(fetch(i)) for i in range(8)]

    print([task.result() for task in tasks])

if __name__ == "__main__":
    asyncio.run(main())
同一时刻最多有三个任务位于受保护的操作段内。TaskGroup 等待组内任务完成;若一个任务抛出非取消异常,它会取消其余任务,等待清理,并通常以 ExceptionGroup 的形式向外报告异常。
超时的范围就是你的产品语义
如果用户要求“从收到请求开始,最多等待一秒”,就要把 timeout 放到获取 Semaphore 的外侧,让排队等待也计入截止时间。若放在内侧,则只限制实际执行时间。两种写法都可能合理,但含义不同。
不要吞掉 CancelledError;在 finally 中完成必要清理后,让取消正常传播。超时通常通过取消当前任务生效,因此需要底层操作配合。同步阻塞代码若卡住事件循环,异步超时也无法及时打断它。
限制活跃操作,不等于限制任务总数
示例只有八个任务,直接创建很清楚。但把范围换成一百万,Semaphore 仍然只控制活跃操作,并不能阻止一百万个 Task 同时占据内存。大量输入更适合固定数量的 worker 配合有界 asyncio.Queue,让生产者在队列满时等待。
- Semaphore:限制某段代码里同时活跃的操作数量。
- 有界 Queue:限制尚未处理的缓冲项目数量。
- 连接池:管理连接资源及其复用,与业务并发限制配合。
- 重试预算:限制次数和总耗时,避免故障期间制造更多负载。
先分清 I/O 工作和 CPU 工作
asyncio 很适合组合可等待的 I/O。大量 Python CPU 计算直接写在协程中,仍会阻塞事件循环。同步 I/O 可以考虑 to_thread;对于受 GIL 限制的纯 Python CPU 任务,线程通常不能直接带来多核加速,应评估进程或其他执行方式。