 WMX · 随记
Python 生成器:把“一次装下”改成“逐个处理”
用一个小型日志统计示例,理解 yield、迭代器耗尽,以及惰性处理的内存边界。
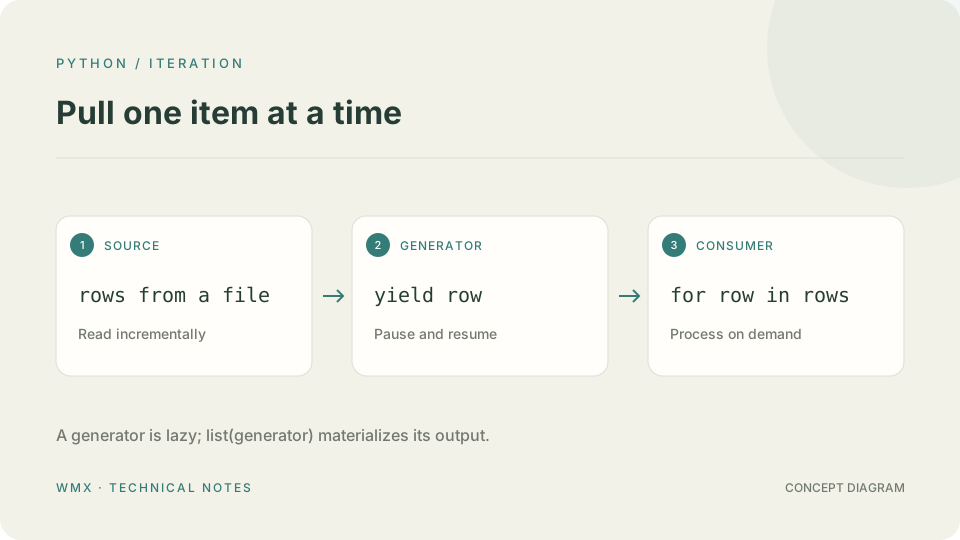
处理文件时,最顺手的写法常常是先把所有内容读进来,再筛选和统计。但如果最终只需要一个计数,保留所有行没有带来额外价值。生成器让程序按消费速度推进,把数据流动的过程表达出来。
yield 不是一次特殊的 return
包含 yield 的普通函数在调用后返回生成器对象;函数体通常要等到迭代发生时才开始执行。每次 yield 交出一个值,并保留当前执行状态,下次迭代再从暂停处继续。return 则结束当前生成器。
from collections import Counter
from io import StringIO

def levels(lines):
    for line in lines:
        text = line.strip()
        if not text:
            continue
        level, _, _message = text.partition(" ")
        yield level

sample = StringIO("INFO started\nERROR timeout\nINFO done\n\n")
stream = levels(sample)
counts = Counter(stream)
print(dict(counts))  # {'INFO': 2, 'ERROR': 1}
print(list(stream))  # []:已经耗尽,不会自动重新开始
把 StringIO 替换为 with open(...) 获得的文本文件对象,处理方式保持不变。文件迭代器会逐行读取,不必先调用 readlines。资源的生命周期应覆盖整个消费过程。
资源关闭以后,惰性读取就晚了
def file_levels(path):
    with open(path, encoding="utf-8") as handle:
        yield from levels(handle)

# 在调用者中完整消费:
# counts = Counter(file_levels("app.log"))
这里 with 位于生成器内部,因此消费时文件仍然处于打开状态。如果消费者提前停止并长期保留生成器,文件也可能继续保持打开。需要严格关闭时,可以让调用者管理文件上下文,或者使用 contextlib.closing 管理这个带 close 方法的生成器。
不是用了生成器,就一定省内存
- list(generator) 会把所有输出重新收集到内存。
- sorted(generator) 需要接收完整输入再排序。
- Counter 的空间取决于不同键的数量;若每行都是唯一键,它也会增长。
- 生成器中保存的缓存、闭包引用和大对象,同样需要计算在内。
在这个例子中,日志级别的种类很少,因此计数器很小。换成按每个用户或请求 ID 分组时,就应该重新评估内存上限。
观察峰值,而不是只看对象本身的大小
sys.getsizeof(generator) 只看到对象自身,不能表示完整处理过程的峰值内存。可以用 tracemalloc 对同一输入规模的两种实现进行比较,再根据需要观察进程级内存。测量时记录输入规模、Python 版本和收集结果的方式。