 WMX · 随记
只用标准库处理 CSV:编码、校验与流式汇总
让 CSV 脚本从“能跑一次”变成可检查的工具,明确坏数据该报错还是跳过。
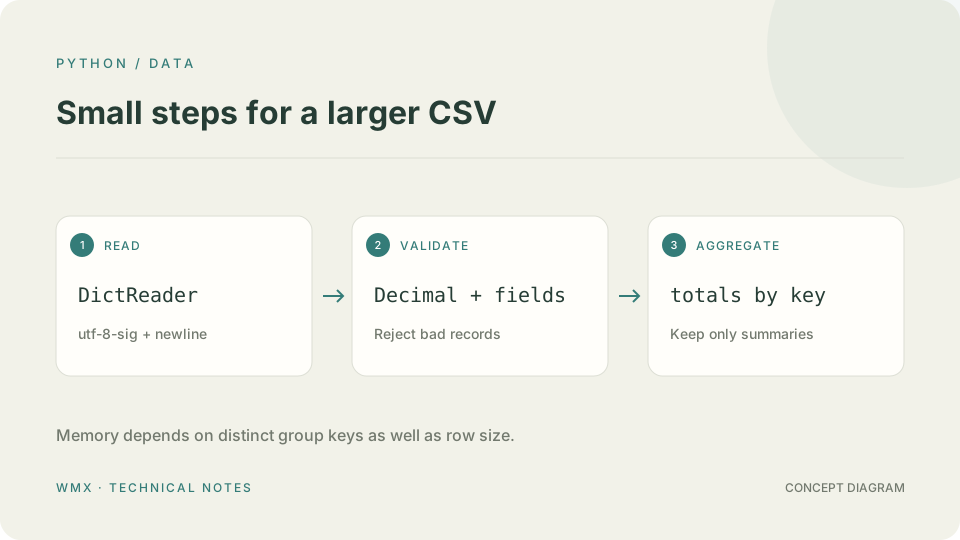
CSV 看起来是逗号分隔文本,却不能简单地对每一行 split(",")。字段内部可能包含逗号、引号和换行。Python 的 csv 模块已经处理了这些格式细节,脚本更应该关注数据契约。
先把输入约束写下来
下面假设表头只有 account 和 amount 两列,账户不能为空,金额是有限的十进制数;遇到坏行立即报告错误,不静默跳过。汇总结果按账户保存,而不是保留所有原始行。
import csv
from collections import defaultdict
from decimal import Decimal, InvalidOperation
from io import StringIO

def summarize(handle):
    reader = csv.DictReader(handle, strict=True)
    if reader.fieldnames != ["account", "amount"]:
        raise ValueError("expected header: account,amount")
    totals = defaultdict(lambda: Decimal("0"))
    for row in reader:
        if None in row or any(v is None for v in row.values()):
            raise ValueError(f"bad column count near line {reader.line_num}")
        account = row["account"].strip()
        if not account:
            raise ValueError(f"empty account near line {reader.line_num}")
        try:
            amount = Decimal(row["amount"].strip())
        except InvalidOperation as error:
            raise ValueError(f"bad amount near line {reader.line_num}") from error
        if not amount.is_finite():
            raise ValueError(f"non-finite amount near line {reader.line_num}")
        totals[account] += amount
    return dict(totals)

sample = StringIO("account,amount\nalice,12.50\nbob,3.00\nalice,-2.50\n")
print(summarize(sample))
# {'alice': Decimal('10.00'), 'bob': Decimal('3.00')}

# 处理真实文件时:
# with open("payments.csv", encoding="utf-8-sig", newline="") as source:
#     totals = summarize(source)
为什么是 newline="" 和 utf-8-sig
使用 newline="" 让 csv 模块自己处理换行,包括带引号字段中的换行。utf-8-sig 可以兼容文件开头带 UTF-8 BOM 的输入,避免第一个表头多出不可见字符。它不是自动编码检测;如果文件来自其他编码,仍需要明确约定或先转换。
金额的语法检查还不是业务检查
Decimal 能解析指数形式和超长数字,默认算术上下文也有精度限制。真实业务还应约束最大金额、小数位数、负数规则和累计精度。示例接受负数用于展示退款汇总,不代表所有数据都应该允许负金额。
逐行处理,空间仍有一个变量
程序不会保存所有行,但字典会为每个不同账户保存一个汇总值。如果账户数量和行数一起增长,内存也会增长。需要对高基数分组设上限,或使用数据库、外部排序和分批归并。
不要默默扔掉异常行
- 小型一次性任务:快速失败通常更容易排查和重跑。
- 批处理任务:可以把错误记录写入单独文件,并报告输入、成功和失败数量。
- 存在跨行字段时:reader.line_num 是已经读取的物理行位置,不是简单的记录序号。
- 输入来自不可信来源时:限制文件大小、字段长度和总行数,避免无限消耗资源。