3 分钟阅读
Sigmoid:概率形状与饱和区的梯度
把任意实数映射到零和一之间,可用 sigmoid。输入绝对值很大时输出接近端点,梯度也会变小。
 WMX · 随记
把任意实数映射到零和一之间,可用 sigmoid。输入绝对值很大时输出接近端点,梯度也会变小。
训练循环通常被框架隐藏,但参数更新可以从一个只有斜率的模型看清楚。数据、预测、损失、梯度和更新各有职责。
手写一个求导公式后,符号或系数错误可能让优化器朝反方向走。有限差分能作为小规模梯度检查工具。
分类模型选对标签并不说明概率分布理想。正确类别得到 0.51 和 0.99,虽然预测标签相同,训练损失却不同。
对很大的 logits 直接取指数会溢出。概率公式在数学上有效,不代表朴素实现能在有限精度下稳定工作。
把低概率词排除能限制采样空间,但 top-k 是按候选数量截断,与按累计概率截断的 top-p 不同。理解这一点有助于解释生成变化。
调低温度常被理解为“更准确”,但它直接改变的是采样分布的集中程度。模型若把错误答案排在首位,更集中也可能更稳定地输出错误。
语言模型输出下一个符号听起来抽象。先用相邻字符的频率做一个极小模型,可以直观看到“给定上下文,得到候选分布”的过程。
把检索片段一直追加到提示词里,可能在提交请求时超过上下文限制。只检查用户输入长度,会忽略系统指令、历史对话和输出预留。
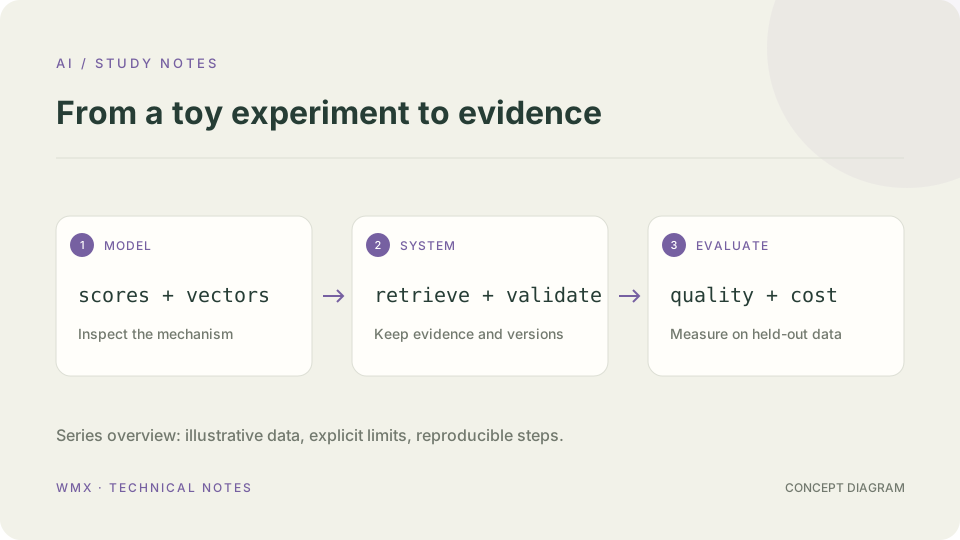
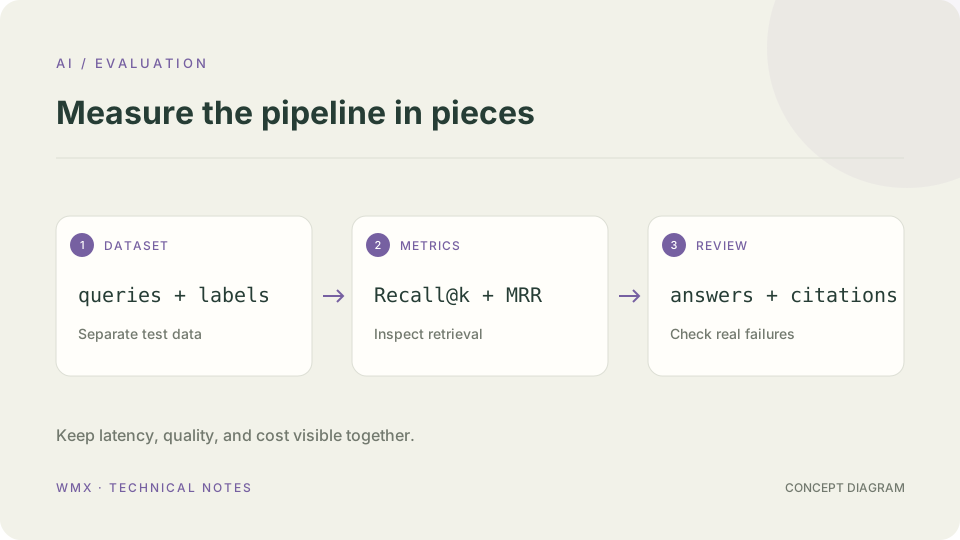
从 Recall@k 和 MRR 开始,将检索质量、回答依据、耗时与成本分开观察。
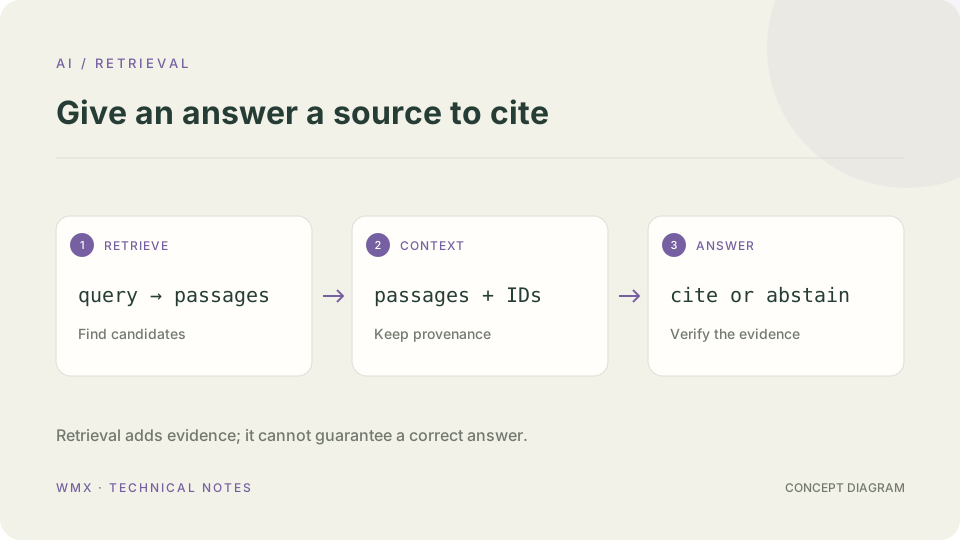
拆开检索、上下文组织与答案生成,理解引用、拒答和资料权限为什么需要单独设计。
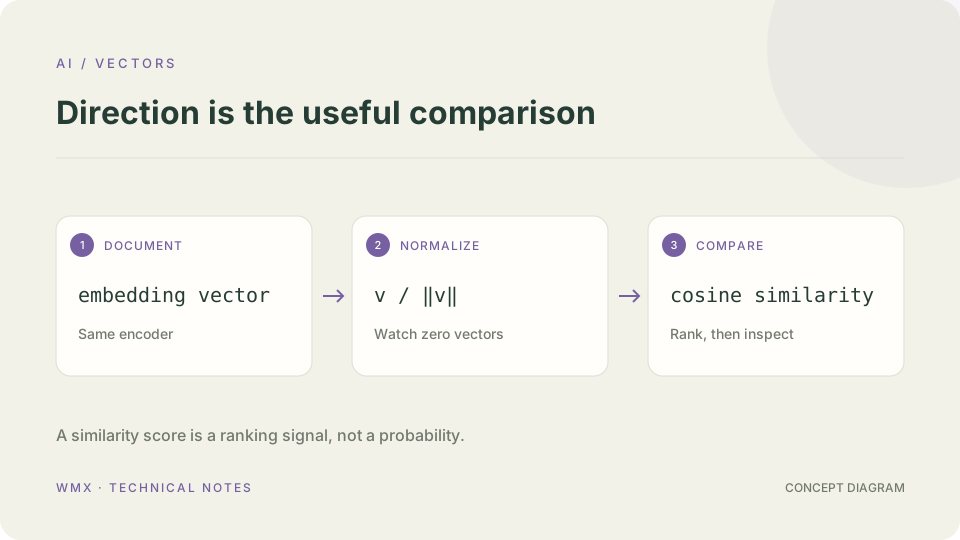
用标准库实现余弦相似度,再分清相似度、概率和检索阈值之间的区别。